Je wilt AI gebruiken, maar je klantdata, code of interne documenten liever niet naar een clouddienst sturen. Dan is lokaal AI draaien een logische stap. Je draait een taalmodel (LLM) dan op je eigen hardware, op kantoor of thuis. Maar welke AI-hardware heb je daarvoor nodig? In deze gids lees je waar het echt om draait: geheugen, geheugenbandbreedte, kwantisatie, verbruik en koeling. Daarna vind je een keuzehulp per situatie, de AI-hardware uit onze collectie en antwoorden op veelgestelde vragen.
Waarom lokaal AI draaien?
Voor wie crypto in een hardware wallet bewaart, klinkt het principe bekend: zelf in controle, je data blijft bij jou. Bij lokale AI werkt het net zo.
Privacy
Draait het model op je eigen hardware, dan hoeven je prompts, documenten en resultaten je eigen netwerk niet te verlaten. Dat is prettig als je werkt met klantgegevens, broncode, contracten of andere vertrouwelijke informatie.
Kosten
Bij een cloud-API betaal je meestal per gebruik of per abonnement. Met eigen hardware doe je een eenmalige investering en betaal je daarna vooral stroom. Of dat voordeliger is, hangt af van hoe intensief je AI gebruikt. Voor teams die dagelijks veel met AI werken, kan het de moeite waard zijn om dat door te rekenen.
Controle
Je kiest zelf welk model je draait, welke versie en hoe je het instelt. Je bent niet afhankelijk van wijzigingen in de voorwaarden, modellen of beschikbaarheid van een externe dienst. En je kunt modellen ook fine-tunen of koppelen aan je eigen documenten.
Waar draait het om bij AI-hardware?
Bij een gewone pc kijk je vaak naar de processor. Bij AI-hardware zijn andere specificaties belangrijker. Dit zijn de vijf punten die het verschil maken.
1. Geheugen (VRAM) bepaalt hoe groot je model mag zijn
Een taalmodel bestaat uit miljarden parameters. Die moeten in het geheugen van je GPU (VRAM) of in het gedeelde geheugen van je systeem passen. Hoeveel geheugen een model nodig heeft, reken je grof uit met: aantal parameters × aantal bytes per parameter.
NVIDIA geeft als voorbeeld een model van 7 miljard parameters in 16-bit precisie (2 bytes per parameter): dat neemt ongeveer 14 GB geheugen in beslag, alleen voor de gewichten van het model (NVIDIA). Daar komt nog geheugen bij voor de zogenoemde KV-cache. Die groeit mee met de lengte van je tekst (context) en het aantal gelijktijdige gebruikers.
Zo ziet die rekensom eruit voor een paar modelgroottes (alleen de gewichten, zonder KV-cache en overhead):
| Modelgrootte | 16-bit (2 bytes) | 8-bit (1 byte) | 4-bit (0,5 byte) |
|---|---|---|---|
| 7 miljard parameters | ± 14 GB | ± 7 GB | ± 3,5 GB |
| 30 miljard parameters | ± 60 GB | ± 30 GB | ± 15 GB |
| 70 miljard parameters | ± 140 GB | ± 70 GB | ± 35 GB |
Houd in de praktijk ruimte over voor de KV-cache en de software zelf. Een model dat precies in je geheugen past, laat weinig ruimte voor lange teksten.
2. Kwantisatie: hetzelfde model, minder geheugen
Kwantisatie betekent dat je de getallen in een model met minder precisie opslaat, bijvoorbeeld met 8 of 4 bits in plaats van 16 bits. Volgens Hugging Face halveert 8-bit kwantisatie het geheugengebruik (Hugging Face). Met 4 bits wordt het model nog kleiner. Populaire tools zoals llama.cpp ondersteunen meerdere niveaus, van 1,5 tot 8 bits.
Het nadeel: hoe sterker je kwantiseert, hoe groter de kans dat de kwaliteit van de antwoorden iets afneemt. Kwantisatie maakt het dus mogelijk om een groter model op dezelfde hardware te draaien, maar het is altijd een afweging tussen geheugen en kwaliteit.
3. Geheugenbandbreedte bepaalt de snelheid
Als een model tekst genereert, maakt het telkens één woorddeel (token) tegelijk. Bij elke stap moeten de gewichten uit het geheugen worden gelezen. NVIDIA beschrijft dit genereren daarom als een proces dat vaak wordt begrensd door de geheugenbandbreedte, niet door de rekenkracht (NVIDIA).
Simpel gezegd: geheugen bepaalt wat er past, bandbreedte bepaalt hoe snel het gaat. Een systeem met veel geheugen maar een lagere bandbreedte kan grote modellen laden, maar genereert per token trager dan een kaart met een veel hogere bandbreedte.
4. Verbruik en koeling
Professionele AI-kaarten verbruiken tot 600 W. Dat vraagt om een zware voeding, de juiste stroomaansluiting en goede koeling. Let vooral op het verschil tussen actieve koeling (met eigen ventilator, geschikt voor een workstation) en passieve koeling (zonder ventilator, afhankelijk van de krachtige luchtstroom in een server). Een passief gekoelde kaart is niet geschikt voor een gewone pc-behuizing.
5. Workstation of server?
- Workstation: een krachtige desktop onder of op je bureau. Je werkt er direct op, met beeldschermen eraan. Kaarten met actieve koeling en DisplayPort-uitgangen passen hier goed.
- Server: een systeem in een serverkast of datacenter, vaak gedeeld door een team. Hier horen passief gekoelde kaarten thuis, eventueel meerdere naast elkaar.
- Compacte AI-computer: een kant-en-klaar systeem met CPU, GPU en veel gedeeld geheugen in één kleine behuizing. Handig als je geen workstation wilt samenstellen.
Keuzehulp: welke AI-hardware past bij jou?
| Jouw situatie | Kijk naar |
|---|---|
| Je wilt een compleet, compact AI-systeem op je bureau om grote modellen lokaal te testen en ontwikkelen | NVIDIA DGX Spark |
| Je wilt nog grotere modellen draaien met twee compacte systemen | Twee DGX Sparks + QSFP-kabel |
| Je hebt een workstation en wilt maximale prestaties uit één kaart | RTX PRO 6000 Blackwell Workstation Edition |
| Je wilt meerdere kaarten in één workstation, of een lager verbruik per kaart | RTX PRO 6000 Blackwell Max-Q |
| Je hebt genoeg aan 84 GB GPU-geheugen in een workstation | RTX PRO 5500 Blackwell 84GB |
| Je bouwt een AI-server met serverluchtstroom | RTX PRO 6000 Blackwell Server Edition |
| Je hebt maximale geheugenbandbreedte nodig en wilt GPU's koppelen in een server | H200 NVL 141GB |
Twijfel je? Neem contact met ons op en vertel welke modellen en toepassingen je in gedachten hebt.
De AI-hardware uit onze collectie
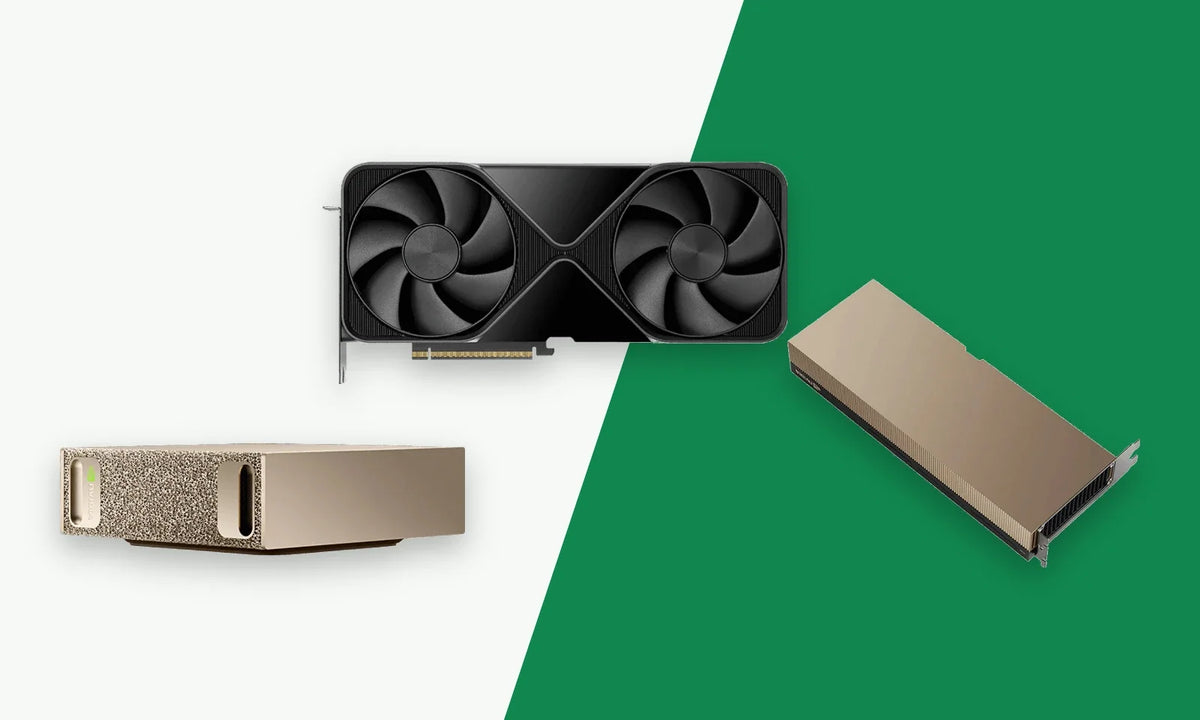
Hieronder zie je de producten uit onze collectie AI Hardware & Servers, met de specificaties die er voor lokaal AI draaien het meest toe doen.
NVIDIA DGX Spark Blackwell
De DGX Spark is een compacte AI-computer van 150 × 150 × 50,5 mm. Binnenin zit de NVIDIA GB10 Grace Blackwell Superchip met een 20-core Arm-processor en 128 GB LPDDR5x unified memory, gedeeld tussen CPU en GPU. Volgens NVIDIA draai je er AI-modellen tot 200 miljard parameters op, en met twee gekoppelde systemen tot 405 miljard parameters (NVIDIA).
- Tot 1 PFLOP AI-rekenkracht (FP4, met sparsity)
- Geheugenbandbreedte: 273 GB/s
- 4 TB NVMe-opslag met zelfversleuteling
- ConnectX-7 met 2× QSFP (tot 200 Gb/s), 10 GbE en Wi-Fi 7
- Externe adapter van 240 W
- Geleverd met NVIDIA DGX OS (gebaseerd op Ubuntu)
Goed om te weten: door de Arm-architectuur werkt niet alle x86-software. En de bandbreedte is lager dan bij de losse GPU's hieronder. De DGX Spark blinkt dus vooral uit in het laden van grote modellen in een klein, zuinig systeem.
PNY DGX Spark Bundle Cable QSFP naar QSFP 112G (0,5 m)
Met deze QSFP-kabel koppel je twee DGX Sparks via hun ConnectX-7-poorten. De kabel ondersteunt tot 112G en is 50 cm lang, dus de twee systemen staan direct naast elkaar.
PNY NVIDIA RTX PRO 6000 Blackwell Workstation Edition
De RTX PRO 6000 Workstation Edition is de krachtigste workstationkaart in de collectie.
- 96 GB GDDR7 met ECC (512-bit)
- Geheugenbandbreedte: 1792 GB/s
- 4000 AI TOPS (FP4, met sparsity) en 24.064 CUDA-cores
- Actieve koeling (double flow-through)
- 600 W total board power, 16-pins stroomaansluiting
- Multi-Instance GPU: tot vier aparte instanties
Goed om te weten: je hebt een zware voeding en een ruime behuizing nodig; de kaart is 12 inch lang en dual-slot.
PNY NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition
De Max-Q-versie heeft hetzelfde geheugen, maar een verbruik van 300 W.
- 96 GB GDDR7 met ECC (512-bit)
- Geheugenbandbreedte: 1792 GB/s
- 3511 AI TOPS (FP4, met sparsity)
- 300 W total board power, actieve koeling, dual-slot
Goed om te weten: de piekprestaties zijn lager dan bij de 600 W-versie. Het lagere verbruik maakt het wel makkelijker om meerdere kaarten in één systeem te plaatsen.
PNY NVIDIA RTX PRO 5500 Blackwell 84GB
De RTX PRO 5500 is een workstationkaart voor wie genoeg heeft aan 84 GB GPU-geheugen.
- 84 GB GDDR7 met ECC (416-bit)
- Geheugenbandbreedte: 1398 GB/s
- 21.760 CUDA-cores
- Actieve koeling, tot 600 W
- MIG: twee afgeschermde instanties van 42 GB
Goed om te weten: de kaart vraagt veel systeem-RAM: minimaal 84 GB, aanbevolen 168 GB.
PNY NVIDIA RTX PRO 6000 Blackwell Server Edition 96GB
De Server Edition is gemaakt voor servers met krachtige luchtstroom.
- 96 GB GDDR7 met ECC (512-bit)
- Geheugenbandbreedte: 1597 GB/s
- 4 PFLOPS FP4 (piek)
- Passieve koeling, 400–600 W (configureerbaar)
Goed om te weten: zonder serverluchtstroom wordt deze kaart niet goed gekoeld. Voor een gewone workstation kies je een versie met actieve koeling.
PNY NVIDIA H200 NVL 141GB
De H200 NVL is een serverkaart op basis van de NVIDIA Hopper-architectuur, met het meeste en snelste geheugen in de collectie.
- 141 GB HBM3e
- Geheugenbandbreedte: 4,8 TB/s
- NVLink-bridge voor 2 of 4 GPU's, tot 900 GB/s per GPU
- MIG: tot zeven afgeschermde instanties
- Passief gekoeld, tot 600 W
Goed om te weten: deze kaart werkt alleen in een geschikt AI- of HPC-serversysteem, niet in een gewone pc.
Zakelijk bestellen
Koop je AI-hardware voor je bedrijf? Op de pagina Zakelijk kopen lees je hoe zakelijk bestellen bij Cryptoken werkt. Heb je vragen over welke kaart of welk systeem bij jouw toepassing past, of wil je meerdere stuks bestellen? Neem contact met ons op.
Veelgestelde vragen
Hoeveel geheugen heb ik nodig om een AI-model lokaal te draaien?
Reken grof met het aantal parameters maal het aantal bytes per parameter. Een model van 7 miljard parameters in 16-bit neemt ongeveer 14 GB in beslag, alleen voor de gewichten. Houd daarnaast ruimte over voor de KV-cache, die groeit met de lengte van je tekst.
Wat is belangrijker: geheugen of rekenkracht?
Voor het draaien van taalmodellen is geheugen meestal het eerste waar je tegenaan loopt: past het model niet, dan draait het niet goed. Daarna bepaalt vooral de geheugenbandbreedte hoe snel tekst wordt gegenereerd. Rekenkracht speelt een grotere rol bij trainen en bij veel gelijktijdige gebruikers.
Gaat de kwaliteit achteruit door kwantisatie?
Dat kan. Met 8 bits is het verschil vaak klein; bij sterkere kwantisatie neemt de kans op kwaliteitsverlies toe. Test daarom met je eigen taken welk niveau voor jou goed genoeg is.
Kan ik een serverkaart in mijn workstation zetten?
Liever niet. De RTX PRO 6000 Server Edition en de H200 NVL zijn passief gekoeld en hebben de krachtige luchtstroom van een server nodig. Voor een workstation kies je een kaart met actieve koeling, zoals de Workstation Edition, de Max-Q of de RTX PRO 5500.
Blijft mijn data echt lokaal?
Het model draait op je eigen hardware, dus je prompts en documenten hoeven niet naar een externe AI-dienst. Of er toch data naar buiten gaat, hangt af van de software die je gebruikt en hoe je die instelt. Controleer daarom de instellingen van je tools.
Conclusie
Lokaal AI draaien geeft je privacy, voorspelbare kosten en volledige controle over je modellen. Kijk bij het kiezen van AI-hardware eerst naar het geheugen: dat bepaalt hoe groot je model mag zijn. Kijk daarna naar de geheugenbandbreedte voor de snelheid, en naar verbruik en koeling om te bepalen of je een workstation, een server of een compact systeem nodig hebt. Zoek je een compleet systeem voor op je bureau, kijk dan naar de DGX Spark. Wil je je workstation of server uitbreiden, dan vind je de passende kaarten in onze collectie AI Hardware & Servers.