Sie möchten KI nutzen, aber Ihre Kundendaten, Ihren Code oder interne Dokumente lieber nicht an einen Cloud-Dienst senden. Dann ist es ein logischer Schritt, KI lokal auszuführen. Sie betreiben ein Sprachmodell (LLM) dabei auf Ihrer eigenen Hardware, im Büro oder zu Hause. Doch welche KI-Hardware brauchen Sie dafür? In diesem Leitfaden erfahren Sie, worauf es wirklich ankommt: Speicher, Speicherbandbreite, Quantisierung, Stromverbrauch und Kühlung. Danach finden Sie eine Entscheidungshilfe für jede Situation, die KI-Hardware aus unserer Kollektion und Antworten auf häufig gestellte Fragen.
Warum KI lokal ausführen?
Wer Krypto in einer Hardware-Wallet aufbewahrt, kennt das Prinzip: Sie behalten die Kontrolle, Ihre Daten bleiben bei Ihnen. Bei lokaler KI funktioniert das genauso.
Datenschutz
Läuft das Modell auf Ihrer eigenen Hardware, müssen Ihre Prompts, Dokumente und Ergebnisse Ihr eigenes Netzwerk nicht verlassen. Das ist praktisch, wenn Sie mit Kundendaten, Quellcode, Verträgen oder anderen vertraulichen Informationen arbeiten.
Kosten
Bei einer Cloud-API zahlen Sie meist pro Nutzung oder per Abonnement. Mit eigener Hardware tätigen Sie eine einmalige Investition und zahlen danach vor allem Strom. Ob sich das lohnt, hängt davon ab, wie intensiv Sie KI nutzen. Für Teams, die täglich viel mit KI arbeiten, kann es sich lohnen, das durchzurechnen.
Kontrolle
Sie wählen selbst, welches Modell Sie ausführen, welche Version und wie Sie es konfigurieren. Sie sind nicht von Änderungen an Bedingungen, Modellen oder der Verfügbarkeit eines externen Dienstes abhängig. Außerdem können Sie Modelle feinabstimmen oder mit Ihren eigenen Dokumenten verbinden.
Worauf kommt es bei KI-Hardware an?
Bei einem normalen PC achten Sie oft auf den Prozessor. Bei KI-Hardware sind andere Spezifikationen wichtiger. Diese fünf Punkte machen den Unterschied.
1. Der Speicher (VRAM) bestimmt, wie groß Ihr Modell sein darf
Ein Sprachmodell besteht aus Milliarden von Parametern. Diese müssen in den Speicher Ihrer GPU (VRAM) oder in den gemeinsamen Speicher Ihres Systems passen. Wie viel Speicher ein Modell benötigt, berechnen Sie grob mit: Anzahl der Parameter × Anzahl der Bytes pro Parameter.
NVIDIA nennt als Beispiel ein Modell mit 7 Milliarden Parametern in 16-Bit-Genauigkeit (2 Bytes pro Parameter): Es belegt etwa 14 GB Speicher, allein für die Gewichte des Modells (NVIDIA). Hinzu kommt Speicher für den sogenannten KV-Cache. Er wächst mit der Länge Ihres Textes (Kontext) und der Anzahl gleichzeitiger Nutzer.
So sieht diese Rechnung für einige Modellgrößen aus (nur die Gewichte, ohne KV-Cache und Overhead):
| Modellgröße | 16 Bit (2 Bytes) | 8 Bit (1 Byte) | 4 Bit (0,5 Byte) |
|---|---|---|---|
| 7 Milliarden Parameter | ca. 14 GB | ca. 7 GB | ca. 3,5 GB |
| 30 Milliarden Parameter | ca. 60 GB | ca. 30 GB | ca. 15 GB |
| 70 Milliarden Parameter | ca. 140 GB | ca. 70 GB | ca. 35 GB |
Lassen Sie in der Praxis Platz für den KV-Cache und die Software selbst. Ein Modell, das gerade so in Ihren Speicher passt, lässt wenig Raum für lange Texte.
2. Quantisierung: dasselbe Modell, weniger Speicher
Quantisierung bedeutet, dass Sie die Zahlen in einem Modell mit geringerer Genauigkeit speichern, zum Beispiel mit 8 oder 4 Bit statt 16 Bit. Laut Hugging Face halbiert eine 8-Bit-Quantisierung den Speicherbedarf (Hugging Face). Mit 4 Bit wird das Modell noch kleiner. Beliebte Tools wie llama.cpp unterstützen mehrere Stufen, von 1,5 bis 8 Bit.
Der Nachteil: Je stärker Sie quantisieren, desto größer ist die Wahrscheinlichkeit, dass die Qualität der Antworten etwas nachlässt. Quantisierung ermöglicht es also, ein größeres Modell auf derselben Hardware auszuführen, ist aber immer eine Abwägung zwischen Speicher und Qualität.
3. Die Speicherbandbreite bestimmt die Geschwindigkeit
Wenn ein Modell Text erzeugt, erstellt es jeweils ein Wortteil (Token) nach dem anderen. Bei jedem Schritt müssen die Gewichte aus dem Speicher gelesen werden. NVIDIA beschreibt diese Generierung deshalb als einen Prozess, der häufig durch die Speicherbandbreite begrenzt wird, nicht durch die Rechenleistung (NVIDIA).
Einfach gesagt: Der Speicher bestimmt, was passt, die Bandbreite bestimmt, wie schnell es geht. Ein System mit viel Speicher, aber geringerer Bandbreite kann große Modelle laden, erzeugt aber jeden Token langsamer als eine Karte mit deutlich höherer Bandbreite.
4. Stromverbrauch und Kühlung
Professionelle KI-Karten verbrauchen bis zu 600 W. Das erfordert ein starkes Netzteil, den passenden Stromanschluss und eine gute Kühlung. Achten Sie besonders auf den Unterschied zwischen aktiver Kühlung (mit eigenem Lüfter, geeignet für eine Workstation) und passiver Kühlung (ohne Lüfter, angewiesen auf den starken Luftstrom in einem Server). Eine passiv gekühlte Karte ist für ein normales PC-Gehäuse nicht geeignet.
5. Workstation oder Server?
- Workstation: ein leistungsstarker Desktop unter oder auf Ihrem Schreibtisch. Sie arbeiten direkt daran, mit angeschlossenen Monitoren. Karten mit aktiver Kühlung und DisplayPort-Ausgängen passen hier gut.
- Server: ein System in einem Serverschrank oder Rechenzentrum, oft von einem Team gemeinsam genutzt. Hier gehören passiv gekühlte Karten hin, gegebenenfalls mehrere nebeneinander.
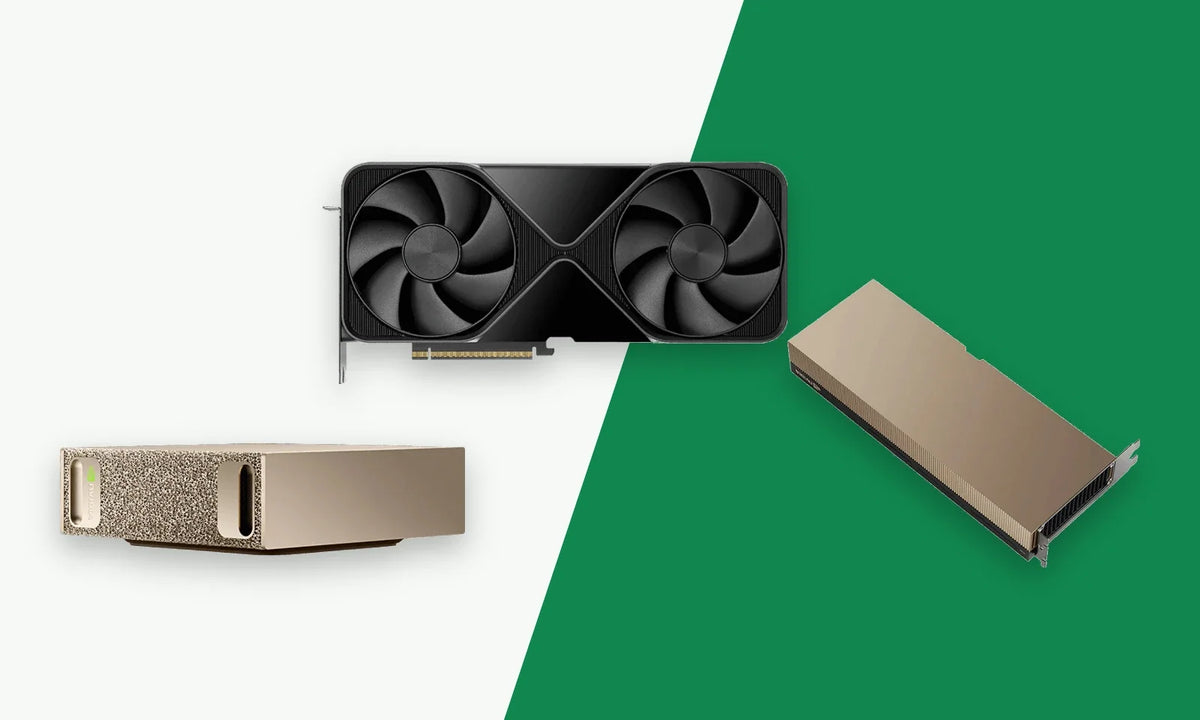
- Kompakter KI-Computer: ein fertiges System mit CPU, GPU und viel gemeinsamem Speicher in einem kleinen Gehäuse. Praktisch, wenn Sie keine Workstation zusammenstellen möchten.
Entscheidungshilfe: Welche KI-Hardware passt zu Ihnen?
| Ihre Situation | Sehen Sie sich an |
|---|---|
| Sie möchten ein komplettes, kompaktes KI-System auf Ihrem Schreibtisch, um große Modelle lokal zu testen und zu entwickeln | NVIDIA DGX Spark |
| Sie möchten noch größere Modelle mit zwei kompakten Systemen ausführen | Zwei DGX Sparks + QSFP-Kabel |
| Sie haben eine Workstation und möchten maximale Leistung aus einer Karte | RTX PRO 6000 Blackwell Workstation Edition |
| Sie möchten mehrere Karten in einer Workstation oder einen geringeren Verbrauch pro Karte | RTX PRO 6000 Blackwell Max-Q |
| Ihnen reichen 84 GB GPU-Speicher in einer Workstation | RTX PRO 5500 Blackwell 84GB |
| Sie bauen einen KI-Server mit Server-Luftstrom | RTX PRO 6000 Blackwell Server Edition |
| Sie benötigen maximale Speicherbandbreite und möchten GPUs in einem Server koppeln | H200 NVL 141GB |
Sie sind unsicher? Kontaktieren Sie uns und teilen Sie uns mit, welche Modelle und Anwendungen Sie im Sinn haben.
Die KI-Hardware aus unserer Kollektion
Nachfolgend sehen Sie die Produkte aus unserer Kollektion AI Hardware & Servers, mit den Spezifikationen, die für die lokale Ausführung von KI am wichtigsten sind.
NVIDIA DGX Spark Blackwell
Der DGX Spark ist ein kompakter KI-Computer mit den Maßen 150 × 150 × 50,5 mm. Im Inneren arbeitet der NVIDIA GB10 Grace Blackwell Superchip mit einem 20-Kern-Arm-Prozessor und 128 GB LPDDR5x Unified Memory, den sich CPU und GPU teilen. Laut NVIDIA führen Sie darauf KI-Modelle mit bis zu 200 Milliarden Parametern aus, mit zwei gekoppelten Systemen bis zu 405 Milliarden Parameter (NVIDIA).
- Bis zu 1 PFLOP KI-Rechenleistung (FP4, mit Sparsity)
- Speicherbandbreite: 273 GB/s
- 4 TB NVMe-Speicher mit Selbstverschlüsselung
- ConnectX-7 mit 2× QSFP (bis zu 200 Gb/s), 10 GbE und Wi-Fi 7
- Externes Netzteil mit 240 W
- Geliefert mit NVIDIA DGX OS (basierend auf Ubuntu)
Gut zu wissen: Wegen der Arm-Architektur läuft nicht jede x86-Software. Und die Bandbreite ist geringer als bei den einzelnen GPUs weiter unten. Der DGX Spark glänzt also vor allem darin, große Modelle in einem kleinen, sparsamen System zu laden.
PNY DGX Spark Bundle Cable QSFP auf QSFP 112G (0,5 m)
Mit diesem QSFP-Kabel koppeln Sie zwei DGX Sparks über ihre ConnectX-7-Anschlüsse. Das Kabel unterstützt bis zu 112G und ist 50 cm lang, die beiden Systeme stehen also direkt nebeneinander.
PNY NVIDIA RTX PRO 6000 Blackwell Workstation Edition
Die RTX PRO 6000 Workstation Edition ist die leistungsstärkste Workstation-Karte der Kollektion.
- 96 GB GDDR7 mit ECC (512 Bit)
- Speicherbandbreite: 1792 GB/s
- 4000 AI TOPS (FP4, mit Sparsity) und 24.064 CUDA-Kerne
- Aktive Kühlung (Double Flow-Through)
- 600 W Total Board Power, 16-Pin-Stromanschluss
- Multi-Instance GPU: bis zu vier separate Instanzen
Gut zu wissen: Sie benötigen ein starkes Netzteil und ein geräumiges Gehäuse; die Karte ist 12 Zoll lang und belegt zwei Steckplätze.
PNY NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition
Die Max-Q-Version hat denselben Speicher, aber einen Verbrauch von 300 W.
- 96 GB GDDR7 mit ECC (512 Bit)
- Speicherbandbreite: 1792 GB/s
- 3511 AI TOPS (FP4, mit Sparsity)
- 300 W Total Board Power, aktive Kühlung, Dual-Slot
Gut zu wissen: Die Spitzenleistung ist geringer als bei der 600-W-Version. Der geringere Verbrauch erleichtert es aber, mehrere Karten in einem System unterzubringen.
PNY NVIDIA RTX PRO 5500 Blackwell 84GB
Die RTX PRO 5500 ist eine Workstation-Karte für alle, denen 84 GB GPU-Speicher genügen.
- 84 GB GDDR7 mit ECC (416 Bit)
- Speicherbandbreite: 1398 GB/s
- 21.760 CUDA-Kerne
- Aktive Kühlung, bis zu 600 W
- MIG: zwei abgeschirmte Instanzen mit je 42 GB
Gut zu wissen: Die Karte benötigt viel System-RAM: mindestens 84 GB, empfohlen 168 GB.
PNY NVIDIA RTX PRO 6000 Blackwell Server Edition 96GB
Die Server Edition ist für Server mit starkem Luftstrom gemacht.
- 96 GB GDDR7 mit ECC (512 Bit)
- Speicherbandbreite: 1597 GB/s
- 4 PFLOPS FP4 (Spitze)
- Passive Kühlung, 400–600 W (konfigurierbar)
Gut zu wissen: Ohne Server-Luftstrom wird diese Karte nicht ausreichend gekühlt. Für eine normale Workstation wählen Sie eine Version mit aktiver Kühlung.
PNY NVIDIA H200 NVL 141GB
Die H200 NVL ist eine Serverkarte auf Basis der NVIDIA-Hopper-Architektur, mit dem meisten und schnellsten Speicher der Kollektion.
- 141 GB HBM3e
- Speicherbandbreite: 4,8 TB/s
- NVLink-Bridge für 2 oder 4 GPUs, bis zu 900 GB/s pro GPU
- MIG: bis zu sieben abgeschirmte Instanzen
- Passiv gekühlt, bis zu 600 W
Gut zu wissen: Diese Karte funktioniert nur in einem geeigneten KI- oder HPC-Serversystem, nicht in einem normalen PC.
Geschäftlich bestellen
Sie kaufen KI-Hardware für Ihr Unternehmen? Auf der Seite Geschäftlich kaufen erfahren Sie, wie geschäftliche Bestellungen bei Cryptoken funktionieren. Haben Sie Fragen dazu, welche Karte oder welches System zu Ihrer Anwendung passt, oder möchten Sie mehrere Stück bestellen? Kontaktieren Sie uns.
Häufig gestellte Fragen
Wie viel Speicher brauche ich, um ein KI-Modell lokal auszuführen?
Rechnen Sie grob mit der Anzahl der Parameter mal der Anzahl der Bytes pro Parameter. Ein Modell mit 7 Milliarden Parametern in 16 Bit belegt etwa 14 GB, allein für die Gewichte. Lassen Sie außerdem Platz für den KV-Cache, der mit der Länge Ihres Textes wächst.
Was ist wichtiger: Speicher oder Rechenleistung?
Beim Ausführen von Sprachmodellen stoßen Sie meist zuerst an die Grenze des Speichers: Passt das Modell nicht, läuft es nicht gut. Danach bestimmt vor allem die Speicherbandbreite, wie schnell Text erzeugt wird. Die Rechenleistung spielt beim Training und bei vielen gleichzeitigen Nutzern eine größere Rolle.
Leidet die Qualität unter der Quantisierung?
Das ist möglich. Mit 8 Bit ist der Unterschied oft gering; bei stärkerer Quantisierung steigt das Risiko eines Qualitätsverlusts. Testen Sie deshalb mit Ihren eigenen Aufgaben, welche Stufe für Sie gut genug ist.
Kann ich eine Serverkarte in meine Workstation einbauen?
Besser nicht. Die RTX PRO 6000 Server Edition und die H200 NVL sind passiv gekühlt und benötigen den starken Luftstrom eines Servers. Für eine Workstation wählen Sie eine Karte mit aktiver Kühlung, etwa die Workstation Edition, die Max-Q oder die RTX PRO 5500.
Bleiben meine Daten wirklich lokal?
Das Modell läuft auf Ihrer eigenen Hardware, Ihre Prompts und Dokumente müssen also nicht an einen externen KI-Dienst gehen. Ob dennoch Daten nach außen gelangen, hängt von der verwendeten Software und deren Konfiguration ab. Prüfen Sie deshalb die Einstellungen Ihrer Tools.
Fazit
Wenn Sie KI lokal ausführen, profitieren Sie von Datenschutz, planbaren Kosten und voller Kontrolle über Ihre Modelle. Achten Sie bei der Wahl der KI-Hardware zuerst auf den Speicher: Er bestimmt, wie groß Ihr Modell sein darf. Achten Sie danach auf die Speicherbandbreite für die Geschwindigkeit sowie auf Stromverbrauch und Kühlung, um zu entscheiden, ob Sie eine Workstation, einen Server oder ein kompaktes System benötigen. Sie suchen ein komplettes System für Ihren Schreibtisch? Dann sehen Sie sich den DGX Spark an. Sie möchten Ihre Workstation oder Ihren Server erweitern? Die passenden Karten finden Sie in unserer Kollektion AI Hardware & Servers.